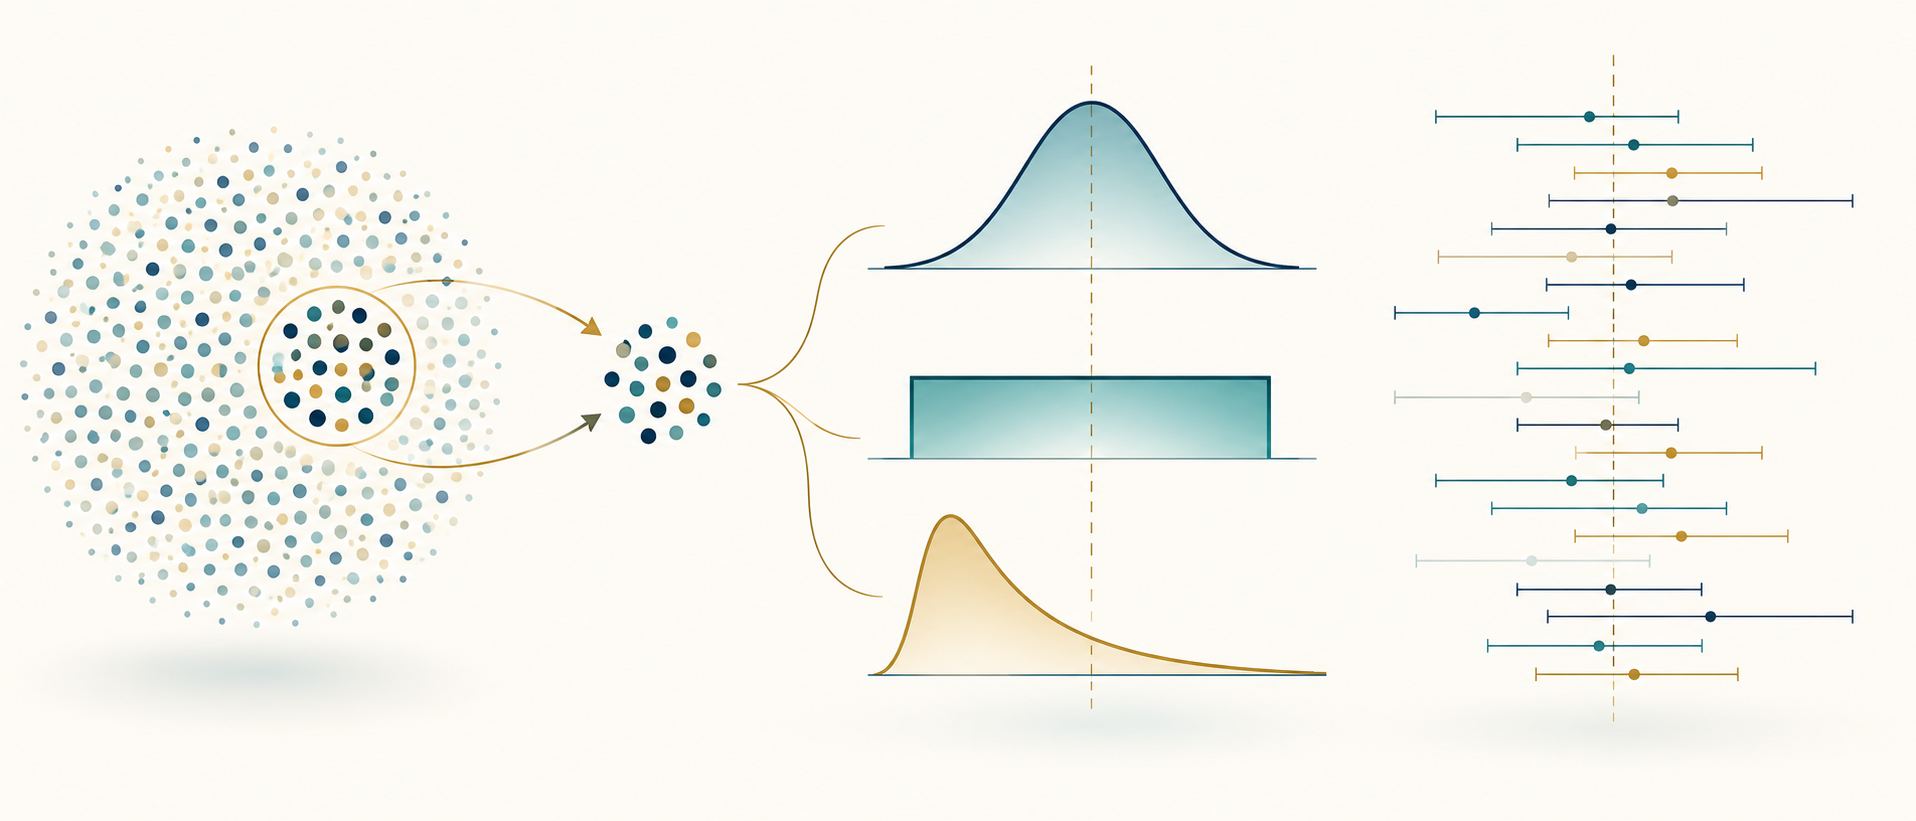
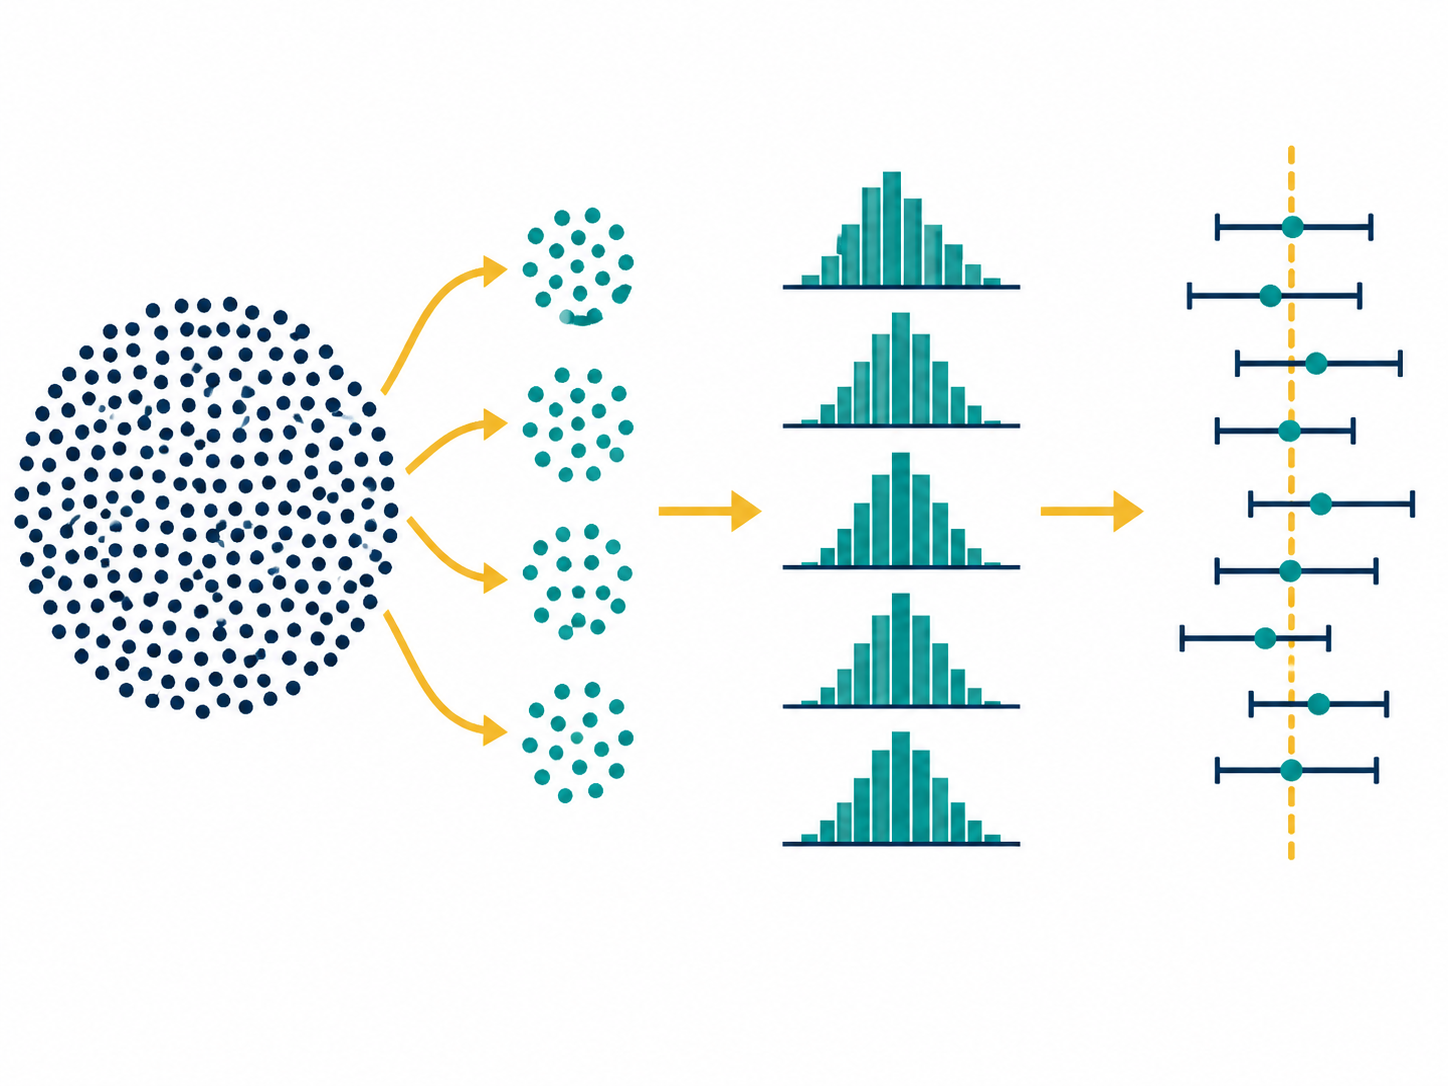
Una curva de probabilidad no nace del histograma: es un modelo que utilizamos para describir un fenómeno y hacer predicciones. El siguiente paso es comprender qué podemos aprender observando solo una muestra. Seguiremos un único hilo: población → variable aleatoria → distribución → muestra → estadístico muestral → distribución del estadístico → intervalo de confianza. Al final cada fórmula tendrá un significado y cada simulación una pregunta precisa.
1. Experimento, variable aleatoria y distribución
Un experimento aleatorio tiene un resultado incierto antes de observarlo, aunque sus condiciones estén definidas. Una variable aleatoria X asigna un número a cada posible resultado: número de aciertos, tiempo de espera, medida. Si los valores posibles están separados, X es discreta; si puede tomar valores dentro de un intervalo, es continua. Una distribución asigna probabilidades a esos valores. Para una variable discreta usamos P(X = x); para una continua, una densidad f(x), cuya área sobre un intervalo representa una probabilidad. En general P(X = x) = 0 para un valor continuo aislado.
La función de distribución acumulada F(x) = P(X ≤ x) suma la probabilidad hasta x. La media teórica E(X) sitúa la distribución; la varianza Var(X) mide la dispersión cuadrática; la desviación estándar es su raíz cuadrada. Son propiedades del modelo, no cifras que cambien con cada muestra. Un buen laboratorio muestra a la vez fórmula, parámetros, gráfica, significado y datos simulados.
2. Las ocho distribuciones del nivel básico
Bernoulli. Un ensayo tiene dos resultados, codificados como 1 (éxito) y 0 (fracaso), con probabilidad de éxito p, 0 ≤ p ≤ 1. P(X=1)=p; P(X=0)=1−p; E(X)=p; Var(X)=p(1−p). Ejemplo: respuesta correcta o incorrecta. Simula muchos ensayos y compara la proporción de éxitos con p: no tienen por qué coincidir en todas las series.
Binomial. Cuenta los éxitos en n ensayos de Bernoulli independientes con la misma p. Para k de 0 a n, P(X=k)=C(n,k)p^k(1−p)^(n−k); E(X)=np; Var(X)=np(1−p). Ejemplo: aciertos en 20 lanzamientos o respuestas. Cambia n y p para observar cómo varía la forma y cómo las frecuencias simuladas se acercan a las probabilidades teóricas.
Poisson. Cuenta sucesos en un intervalo fijo cuando el modelo supone sucesos independientes y una tasa media constante λ > 0. Para k = 0,1,2,…, P(X=k)=e^(−λ)λ^k/k!; E(X)=λ; Var(X)=λ. Ejemplo: llegadas durante un período. Cambia λ y observa el centro y la dispersión; no confundas el recuento con el tiempo entre dos llegadas.
Uniforme continua. En [a,b], con a < b, intervalos de igual longitud tienen igual probabilidad: f(x)=1/(b−a) dentro de [a,b] y cero fuera; E(X)=(a+b)/2; Var(X)=(b−a)^2/12. Simula una muestra y compara su histograma imperfectamente plano con la densidad teórica perfectamente plana.
Normal o gaussiana. Continua y simétrica alrededor de la media μ, se describe mediante μ y σ > 0: f(x)=[1/(σ√(2π))] exp(−(x−μ)^2/(2σ²)); E(X)=μ; Var(X)=σ². Cambia μ para mover la campana y σ para ensancharla. Su importancia para las medias muestrales no implica que todo fenómeno real sea Normal.
Exponencial. Continua y no negativa; en un modelo de sucesos con tasa constante describe el tiempo de espera con λ > 0: f(x)=λe^(−λx) para x ≥ 0 y cero en otro caso; E(X)=1/λ; Var(X)=1/λ². Simula esperas y observa la cola derecha. Poisson cuenta sucesos; la Exponencial mide una espera en el modelo correspondiente.
t de Student. Continua y simétrica, depende de los grados de libertad ν. Para observaciones Normales independientes con σ desconocida, T=(x̄−μ)/(s/√n) sigue una t con ν=n−1. Su media es cero si ν > 1 y su varianza es ν/(ν−2) si ν > 2; para ν pequeños sus colas son más pesadas que las de la Normal. Superpón t y Normal estándar mientras ν aumenta: la diferencia disminuye.
Chi-cuadrado. Si Z₁,…,Zν son Normales estándar independientes, χ²=Z₁²+⋯+Zν² tiene ν grados de libertad; E(χ²)=ν; Var(χ²)=2ν. Es positiva y asimétrica, sobre todo para ν pequeños. Ayuda a estudiar la varianza y en algunas pruebas: no confundas la distribución con todas las aplicaciones de la prueba chi-cuadrado. El laboratorio específico compara frecuencias observadas y esperadas.
3. Del modelo a los datos observados
La distribución teórica describe un modelo; una muestra de tamaño n es una posible realización: X₁,…,Xₙ. Calculamos x̄=(X₁+⋯+Xₙ)/n y s²=Σ(Xᵢ−x̄)²/(n−1). El denominador n−1 convierte s² en un estimador insesgado de la varianza bajo muestreo independiente e idénticamente distribuido. Una muestra nueva del mismo modelo cambia x̄, s² y el histograma: esa variabilidad no es un fallo del programa.
Prueba un experimento: elige una distribución y sus parámetros, genera una muestra, anota x̄ y s y pide otra muestra sin cambiar el modelo. Repite. El parámetro poblacional permanece fijo; los estadísticos calculados cambian. Tener 100 observaciones no significa tener 100 poblaciones.
4. La distribución de la media muestral
Extraigamos ahora muestras completas de igual tamaño n repetidas veces y guardemos solo una media por muestra. El histograma obtenido no describe observaciones individuales: describe la distribución muestral de x̄. Para muestras independientes e idénticamente distribuidas, con media μ y varianza finita σ², E(x̄)=μ y SD(x̄)=σ/√n. Esta última cantidad es el error estándar de la media. Cuadruplicar n reduce el error estándar a la mitad; no lo elimina.
El teorema central del límite afirma que, bajo condiciones apropiadas, la distribución de la media estandarizada tiende a la Normal cuando n crece. Si la población es Normal, la media es Normal para cualquier n; con una población uniforme o exponencial podemos observar la aproximación. Compara n = 2, 5, 30 y 100 mediante muchas muestras, colocando el histograma de los valores individuales junto al de las medias. Una fuerte asimetría o dependencia puede hacer que la aproximación sea lenta o inadecuada.
5. ¿Por qué un intervalo de confianza?
La media muestral estima μ pero no expresa por sí sola la precisión de esa estimación. Un intervalo de confianza construye alrededor de x̄ una banda que cambia de muestra a muestra. Su nivel, por ejemplo el 95%, es la cobertura a largo plazo del procedimiento en repeticiones ideales del mismo experimento, bajo las hipótesis del modelo. Una vez observado un intervalo, μ es un valor fijo: no decimos que tenga un 95% de probabilidad de encontrarse dentro. Tampoco decimos que el 95% de las observaciones individuales caigan en él.
6. Media con σ conocida: intervalo z
Cuando la desviación estándar poblacional σ se conoce realmente y la población es Normal, o n es suficientemente grande para justificar la aproximación, el intervalo bilateral es x̄ ± z_(1−α/2)·σ/√n, con nivel 1−α. Los valores críticos habituales son 1,645 para el 90%, 1,960 para el 95% y 2,576 para el 99%. El margen de error aumenta con el nivel exigido y con σ, y disminuye con √n. No se debe presentar una s calculada con la muestra como una σ conocida de antemano.
Ejemplo. Si n=100, x̄=50, σ=10, al 95% el error estándar es 1 y el margen 1,960: el intervalo es [48,04; 51,96]. Al 99% el margen pasa a 2,576 y el intervalo se ensancha. Se gana cobertura, no precisión.
7. Media con σ desconocida: intervalo t
En la práctica σ suele desconocerse. Utilizamos la desviación estándar muestral s y un cuantil de la t de Student: x̄ ± t_(1−α/2,n−1)·s/√n. Los grados de libertad son n−1. En muestras pequeñas la justificación exacta exige una población Normal; incluso con muestras mayores se necesitan independencia y atención a colas, valores atípicos y diseño de recogida. Las colas más pesadas de t suelen producir un intervalo más ancho que z con los mismos datos.
Ejemplo. Para n=16, x̄=75, s=12, el error estándar es 12/√16=3. Al 95%, con 15 grados de libertad, t≈2,131; el margen es aproximadamente 6,39 y el intervalo [68,61; 81,39]. Compara z y t con n = 5, 10, 30 y 100: sus diferencias disminuyen cuando n crece.
8. Ver la cobertura, no solo leer sobre ella
Fija una población cuya media μ conoce el simulador, elige n y un nivel (90%, 95% o 99%) y genera 10, 100, 1.000 o 10.000 muestras independientes. Construye un intervalo por muestra. En una gráfica horizontal dibuja μ como línea vertical; usa un color para los intervalos que la cruzan y otro para los que no. La cobertura observada es intervalos que contienen μ / intervalos totales. No tiene que ser exactamente 95% con diez intervalos; al repetir muchas veces tiende al nivel nominal si se cumplen las hipótesis.
Tres experimentos guiados: reduce n y observa intervalos más largos; aumenta la confianza y compara longitud y cobertura; cambia de z a t al desconocer σ y nota el coste de esa incertidumbre adicional. Una simulación de cobertura t debe recalcular s para cada muestra, no reutilizar una única desviación estándar.
9. Cómo organizar el laboratorio
Seis módulos interactivos hacen naturales los pasos entre conceptos. Explorar una distribución: elegir entre ocho distribuciones, modificar parámetros y leer fórmula, forma y media. Generar una muestra: decidir n e inspeccionar histograma, x̄, s² y s. Repetir el muestreo: reunir muchas medias y compararlas con los datos individuales. Construir un intervalo: fijar 90%, 95% o 99%, distinguir σ conocida y desconocida y ver cada término. Comprobar la cobertura: repetir muestras y colorear intervalos según incluyan μ. Experimentos guiados: contestar «¿Qué cambia si duplico n?» y «¿Por qué el 99% es más ancho que el 95%?», y comprobarlo con gráficas.
Gráficas legibles en el móvil, controles que muestran su valor numérico, botones «Nueva muestra», «Repetir 100», «Repetir 1.000» y «Reiniciar», explicaciones breves junto a los resultados y colores distintos para parámetros teóricos, muestras e intervalos ayudan más que una gráfica espectacular. Una semilla aleatoria opcional hace reproducibles los experimentos. El laboratorio existente permite analizar datos, comparar modelos y calcular intervalos; los módulos de muestreo repetido y cobertura descritos aquí son propuestas de ampliación didáctica, no funciones que demos por existentes.
10. Especificación didáctica para un desarrollo posterior
Las simulaciones básicas pueden ejecutarse íntegramente en el navegador, sin base de datos. La interfaz debería permitir elegir distribución, parámetros y tamaño muestral; generar una muestra y repetir 100 o 1.000 veces; separar visualmente densidad/probabilidades teóricas, histograma observado e histograma de medias; mostrar error estándar e intervalos z/t paso a paso; comparar cobertura observada y esperada sin presentar una sola ejecución como ley. Las ocho distribuciones requieren comprobaciones de los dominios de los parámetros y pruebas numéricas; los intervalos requieren comprobar cuantiles, grados de libertad y casos límite. Una biblioteca gráfica estable puede dibujar gráficos adaptables, pero las fórmulas estadísticas han de implementarse y verificarse explícitamente.
Un panel «Explícame» debería relacionar cada control con una pregunta: «¿Qué permanece fijo en la población?», «¿Qué cambia entre muestras?», «¿Qué distribución describe este histograma?», «¿Qué significa el 95%?». La interfaz debe enseñar a interpretar, no limitarse a producir respuestas.
11. Posibles ampliaciones
Tras el nivel básico pueden añadirse intervalos para una proporción, intervalos de varianza mediante chi-cuadrado, comparación de dos medias o proporciones, bootstrap, contrastes de hipótesis, pruebas de bondad de ajuste, importación CSV y gráficos Q-Q. Cada ampliación requiere sus propias hipótesis: no es simplemente otro botón aplicado indiscriminadamente a los mismos datos. El vínculo natural con el laboratorio existente es pasar con criterio de la exploración de datos a la inferencia.
Conclusión
La teoría explica qué esperar; la simulación muestra qué varía realmente; el intervalo cuantifica la incertidumbre de una estimación. Antes de pulsar, preguntémonos siempre cuál es la población, qué variable medimos, cómo se extrajo la muestra y qué estadístico observamos. Es esa cadena, no una fórmula aislada, lo que hace comprensible la probabilidad aplicada.
Abrir el nuevo laboratorio guiado en seis etapas
Abrir el laboratorio de distribuciones e intervalos de confianza