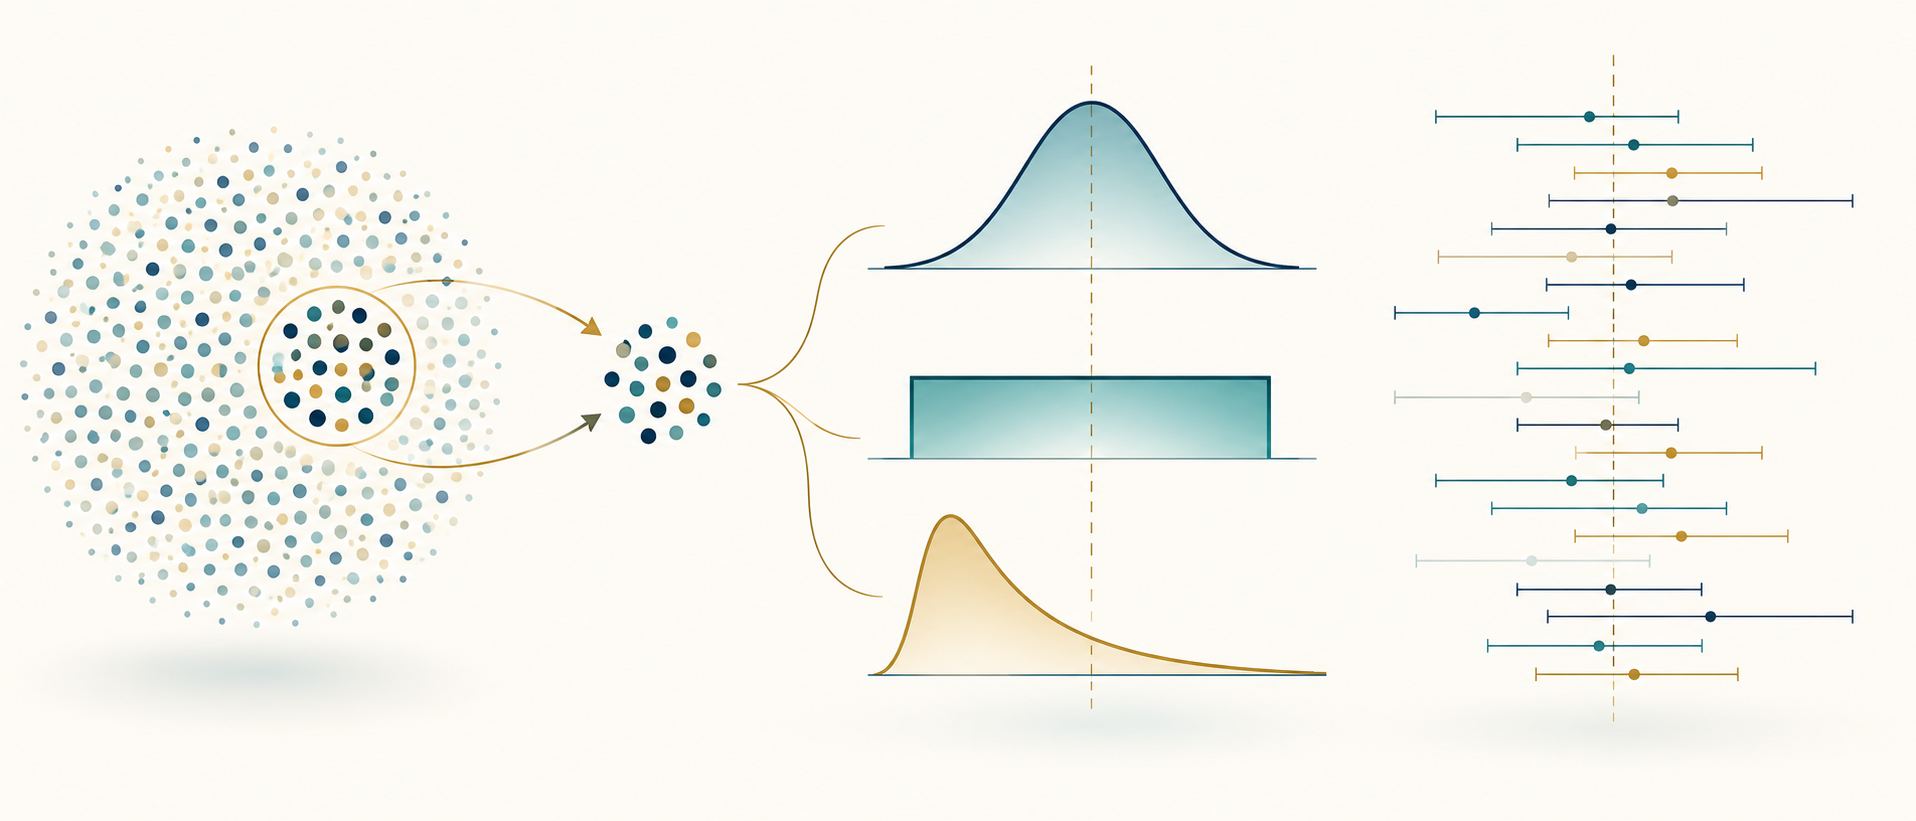
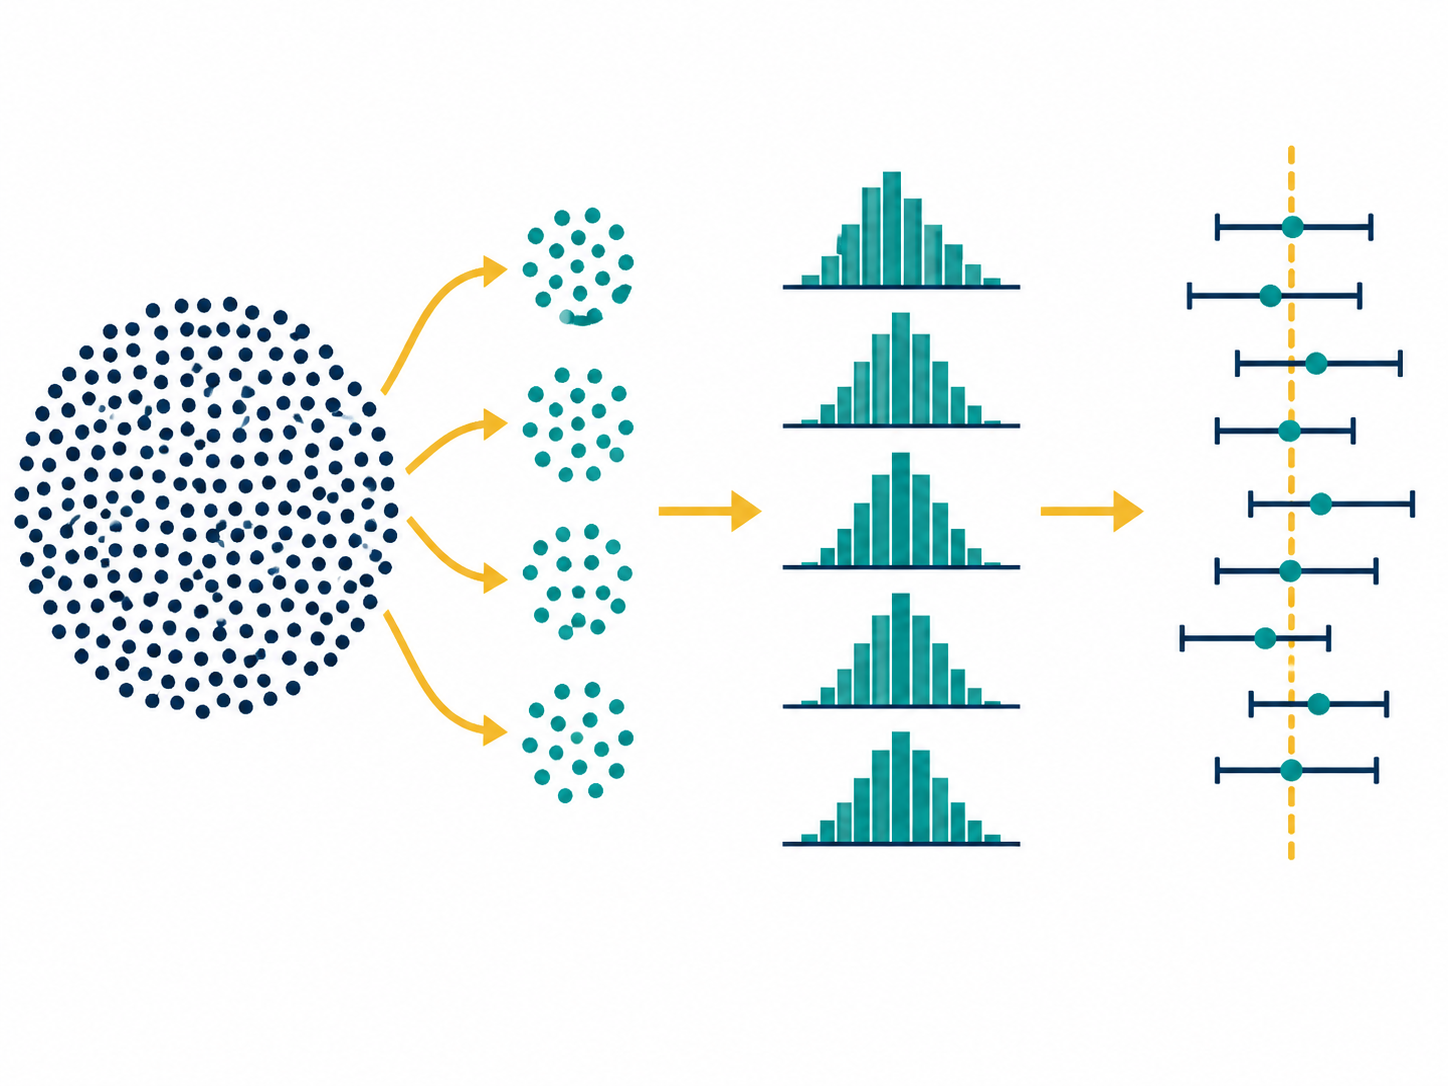
Una curva di probabilità non nasce dall’istogramma: è un modello che usiamo per descrivere un fenomeno e fare previsioni. Il passo successivo è capire che cosa possiamo imparare osservando soltanto un campione. Seguiremo un unico filo: popolazione → variabile casuale → distribuzione → campione → statistica campionaria → distribuzione della statistica → intervallo di confidenza. Alla fine ogni formula avrà un significato e ogni simulazione una domanda precisa.
1. Esperimento, variabile casuale e distribuzione
Un esperimento casuale ha un esito incerto prima dell’osservazione, pur avvenendo in condizioni definite. Una variabile casuale X associa un numero a ogni possibile esito: numero di successi, tempo di attesa, misura di una grandezza. Se i valori sono isolati, X è discreta; se può assumere valori in un intervallo, è continua. Una distribuzione assegna probabilità ai possibili valori. Per una variabile discreta usiamo P(X = x); per una continua una densità f(x), la cui area su un intervallo dà una probabilità. In generale P(X = x) = 0 per un singolo valore continuo.
La funzione di ripartizione F(x) = P(X ≤ x) accumula la probabilità fino a x. La media teorica E(X) descrive il centro della distribuzione; la varianza Var(X) misura la dispersione quadratica; la deviazione standard è la radice della varianza. Sono proprietà del modello, non numeri che cambiano a ogni campione. Nel laboratorio è utile tenere contemporaneamente davanti agli occhi formula, parametri, grafico, significato e dati simulati.
2. Le otto distribuzioni del livello base
Bernoulli. Una prova ha due esiti, codificati 1 (successo) e 0 (insuccesso), con probabilità di successo p, dove 0 ≤ p ≤ 1. P(X=1)=p; P(X=0)=1−p; E(X)=p; Var(X)=p(1−p). Esempio: risposta corretta o errata a una domanda. Simula molte prove e confronta la quota di successi con p: non saranno identiche in ogni sequenza.
Binomiale. Conta i successi in n prove Bernoulli indipendenti con la stessa p. Per k da 0 a n, P(X=k)=C(n,k)p^k(1−p)^(n−k); E(X)=np; Var(X)=np(1−p). Esempio: quanti successi in 20 lanci o risposte. Cambiando n e p osserviamo come cambia la forma e come l’istogramma simulato si avvicina alle probabilità teoriche.
Poisson. Conta eventi in un intervallo fissato quando il modello assume eventi indipendenti e tasso medio costante λ > 0. Per k = 0,1,2,…, P(X=k)=e^(−λ)λ^k/k!; E(X)=λ; Var(X)=λ. Esempio: arrivi in una finestra temporale. Modifica λ e verifica come cambiano centro e dispersione; non confondere il conteggio con il tempo tra due arrivi.
Uniforme continua. Su [a,b], con a < b, intervalli di uguale lunghezza hanno uguale probabilità: f(x)=1/(b−a) dentro [a,b], zero fuori; E(X)=(a+b)/2; Var(X)=(b−a)^2/12. Simula un campione e confronta un istogramma non perfettamente piatto con la densità teorica piatta.
Normale o gaussiana. È continua, simmetrica rispetto alla media μ e descritta da μ e σ > 0: f(x)=[1/(σ√(2π))] exp(−(x−μ)^2/(2σ²)); E(X)=μ; Var(X)=σ². Varia μ per spostare la campana e σ per allargarla. La sua importanza per le medie campionarie non implica che ogni fenomeno reale sia normale.
Esponenziale. È continua e non negativa; in un modello di eventi con tasso costante λ > 0 descrive il tempo di attesa: f(x)=λe^(−λx) per x ≥ 0, zero altrimenti; E(X)=1/λ; Var(X)=1/λ². Simula tempi di attesa e osserva la coda a destra. Una Poisson conta eventi; un’Esponenziale misura un’attesa nel modello corrispondente.
t di Student. È continua, simmetrica e dipende dai gradi di libertà ν. Quando osservazioni normali indipendenti hanno σ sconosciuta, T=(x̄−μ)/(s/√n) segue una t con ν=n−1. La media vale zero se ν > 1 e la varianza vale ν/(ν−2) se ν > 2; per ν piccoli le code sono più pesanti della Normale. Sovrapponi t e Normale standard mentre ν cresce: la differenza diminuisce.
Chi-quadro. Se Z₁,…,Zν sono Normali standard indipendenti, χ²=Z₁²+⋯+Zν² ha ν gradi di libertà; E(χ²)=ν; Var(χ²)=2ν. È positiva e asimmetrica, soprattutto per ν piccoli. È utile per studiare la varianza e per alcuni test: non confondere la distribuzione chi-quadro con ogni applicazione del test chi-quadro. Nel laboratorio dedicato trovi un confronto fra frequenze osservate e attese.
3. Dal modello ai dati osservati
La distribuzione teorica descrive un modello; un campione di ampiezza n è una sua possibile realizzazione: X₁,…,Xₙ. Calcoliamo x̄=(X₁+⋯+Xₙ)/n e s²=Σ(Xᵢ−x̄)²/(n−1). Il denominatore n−1 rende s² uno stimatore non distorto della varianza sotto il campionamento indipendente identicamente distribuito. Un nuovo campione dello stesso modello cambia x̄, s² e istogramma: questa variabilità non è un errore del programma.
Prova un esperimento: scegli una distribuzione e i suoi parametri, genera un campione, registra x̄ e s, quindi premi «nuovo campione» senza cambiare il modello. Ripeti più volte. Il parametro della popolazione resta fermo; le statistiche calcolate cambiano. Avere una misura di 100 osservazioni non significa avere 100 popolazioni.
4. La distribuzione della media campionaria
Ora ripetiamo l’estrazione di interi campioni, tutti della stessa ampiezza n, e conserviamo soltanto una media per campione. L’istogramma risultante non descrive le osservazioni individuali: descrive la distribuzione campionaria di x̄. Per campioni indipendenti identicamente distribuiti con media μ e varianza finita σ², E(x̄)=μ e SD(x̄)=σ/√n. Quest’ultima quantità è l’errore standard della media. Quadruplicare n dimezza l’errore standard, non lo annulla.
Il teorema centrale del limite dice che, sotto condizioni appropriate, la distribuzione della media standardizzata tende alla Normale quando n cresce. Se la popolazione è Normale, la media è Normale per ogni n; se la popolazione è uniforme o esponenziale, osserviamo invece l’avvicinamento. Confronta n = 2, 5, 30 e 100 usando molti campioni: accosta l’istogramma dei singoli valori a quello delle medie. Una forte asimmetria o dipendenza può rendere l’approssimazione lenta o inadeguata.
5. Perché un intervallo di confidenza?
La sola media campionaria stima μ ma non esprime la precisione della stima. Un intervallo di confidenza costruisce attorno a x̄ una fascia che varia da campione a campione. Il suo livello, per esempio 95%, è la percentuale di copertura della procedura in ripetizioni ideali dello stesso esperimento, sotto le ipotesi del modello. Dopo aver osservato un singolo intervallo, μ è un valore fisso: non diciamo che ha il 95% di probabilità di stare nell’intervallo. E non diciamo che il 95% delle osservazioni individuali vi cade.
6. Media con σ nota: intervallo z
Quando la deviazione standard σ della popolazione è realmente nota e la popolazione è Normale, oppure n è abbastanza grande da giustificare l’approssimazione, l’intervallo bilaterale è x̄ ± z_(1−α/2)·σ/√n, con livello 1−α. I valori critici usuali sono 1,645 al 90%, 1,960 al 95% e 2,576 al 99%. Il margine di errore aumenta con il livello richiesto e con σ, diminuisce con √n. Non si deve presentare una s calcolata dal campione come se fosse una σ nota in anticipo.
Esempio. Se n=100, x̄=50, σ=10, al 95% l’errore standard è 1 e il margine è 1,960: l’intervallo è [48,04; 51,96]. Al 99% il margine diventa 2,576 e l’intervallo si allarga. Si guadagna copertura, non precisione.
7. Media con σ sconosciuta: intervallo t
Nella pratica σ è spesso sconosciuta. Si usa la deviazione standard campionaria s e il quantile della t di Student: x̄ ± t_(1−α/2,n−1)·s/√n. I gradi di libertà sono n−1. Se il campione è piccolo, la giustificazione esatta richiede una popolazione Normale; per campioni più grandi servono comunque indipendenza e attenzione a code, valori anomali e modalità di raccolta. Le code più pesanti della t producono, a parità di dati, un intervallo generalmente più largo dello z.
Esempio. Per n=16, x̄=75, s=12, l’errore standard è 12/√16=3. Al 95%, con 15 gradi di libertà, t≈2,131; il margine è circa 6,39 e l’intervallo è [68,61; 81,39]. Ripeti lo stesso confronto z/t per n = 5, 10, 30 e 100: le differenze si riducono al crescere di n.
8. Vedere la copertura, non soltanto leggerla
Fissa una popolazione con media μ nota al simulatore, scegli n e un livello (90%, 95% o 99%), poi genera 10, 100, 1.000 o 10.000 campioni indipendenti. Per ciascuno costruisci l’intervallo. In un grafico orizzontale traccia μ come linea verticale; usa un colore per gli intervalli che la attraversano e un altro per quelli che la mancano. La copertura osservata è intervalli contenenti μ / intervalli totali. Non deve essere esattamente 95% in una prova di 10 intervalli; con molte ripetizioni tende al livello nominale se le ipotesi sono rispettate.
Tre esperimenti guidati: riduci n e osserva intervalli più lunghi; aumenta la confidenza e confronta lunghezza e copertura; passa da z a t senza conoscere σ e nota il costo dell’incertezza aggiuntiva. Una simulazione della copertura deve usare per ogni campione una nuova s nel caso t: non può riciclare una singola deviazione standard.
9. Come organizzare il laboratorio
Un percorso interattivo in sei moduli rende naturale il passaggio fra i concetti. Esplora una distribuzione: scegli fra le otto distribuzioni, modifica parametri e leggi formula, forma e media. Genera un campione: decidi n e osserva istogramma, x̄, s² e s. Ripeti il campionamento: raccogli molte medie e confrontale con la distribuzione dei singoli dati. Costruisci un intervallo: imposta 90%, 95% o 99%, scegli consapevolmente σ nota o sconosciuta e visualizza ogni termine. Verifica la copertura: ripeti campioni e colora gli intervalli secondo il risultato. Esperimenti guidati: rispondi a domande quali «che cosa cambia se raddoppio n?» e «perché il 99% è più largo del 95%?», poi controlla con i grafici.
Grafici leggibili anche sul telefono, cursori con valore numerico visibile, pulsanti «Nuovo campione», «Ripeti 100», «Ripeti 1.000» e «Azzera», spiegazioni brevi accanto ai risultati e distinzione cromatica fra parametro teorico, campione e intervallo aiutano più di un grafico spettacolare. Un seme casuale opzionale rende ripetibili gli esperimenti. Il laboratorio già disponibile consente analisi di dati, confronto di modelli e calcolo di intervalli; i moduli di campionamento ripetuto e copertura qui descritti sono proposte didattiche di ampliamento, non funzioni che l’articolo presume già presenti.
10. Specifica didattica per uno sviluppo successivo
Il progetto può funzionare interamente nel browser, senza database per le simulazioni di base. L’interfaccia dovrebbe permettere di scegliere distribuzione, parametri e numerosità; generare un campione e ripeterlo 100 o 1.000 volte; distinguere visivamente densità/probabilità teorica, istogramma osservato e istogramma delle medie; visualizzare errore standard e intervalli z/t passo passo; mostrare copertura osservata e attesa senza spacciare una singola prova per una legge. Per le otto distribuzioni occorrono controlli dei domini dei parametri e test numerici; per gli intervalli occorrono verifiche dei quantili, dei gradi di libertà e dei casi limite. Una libreria grafica stabile può disegnare grafici responsive, ma le formule statistiche devono essere implementate e verificate esplicitamente.
Un pannello «Spiegami» dovrebbe legare ogni comando a una domanda: «Che cosa resta fisso nella popolazione?», «Che cosa cambia fra i campioni?», «Di quale distribuzione è questo istogramma?», «Che cosa significa 95%?». Così l’interfaccia non si limita a produrre risposte: insegna a interpretarle.
11. Estensioni possibili
Dopo il livello base si possono aggiungere intervalli per una proporzione, intervalli per la varianza tramite chi-quadro, confronto di due medie o proporzioni, bootstrap, test di ipotesi, test di adattamento, importazione CSV e grafici Q-Q. Ciascuna estensione richiede le proprie ipotesi: non è un nuovo pulsante applicato indiscriminatamente agli stessi dati. Il collegamento naturale con il laboratorio esistente è partire dall’esplorazione dei dati e passare, con consapevolezza, all’inferenza.
Conclusione
La teoria spiega che cosa aspettarsi; la simulazione mostra che cosa varia davvero; l’intervallo quantifica l’incertezza di una stima. Prima di fare clic chiediamoci sempre quale sia la popolazione, quale variabile stiamo misurando, come è stato estratto il campione e quale statistica stiamo osservando. È questa catena, non una formula isolata, che rende comprensibile la probabilità applicata.
Apri il nuovo laboratorio guidato in sei tappe
Apri il laboratorio delle distribuzioni e degli intervalli di confidenza