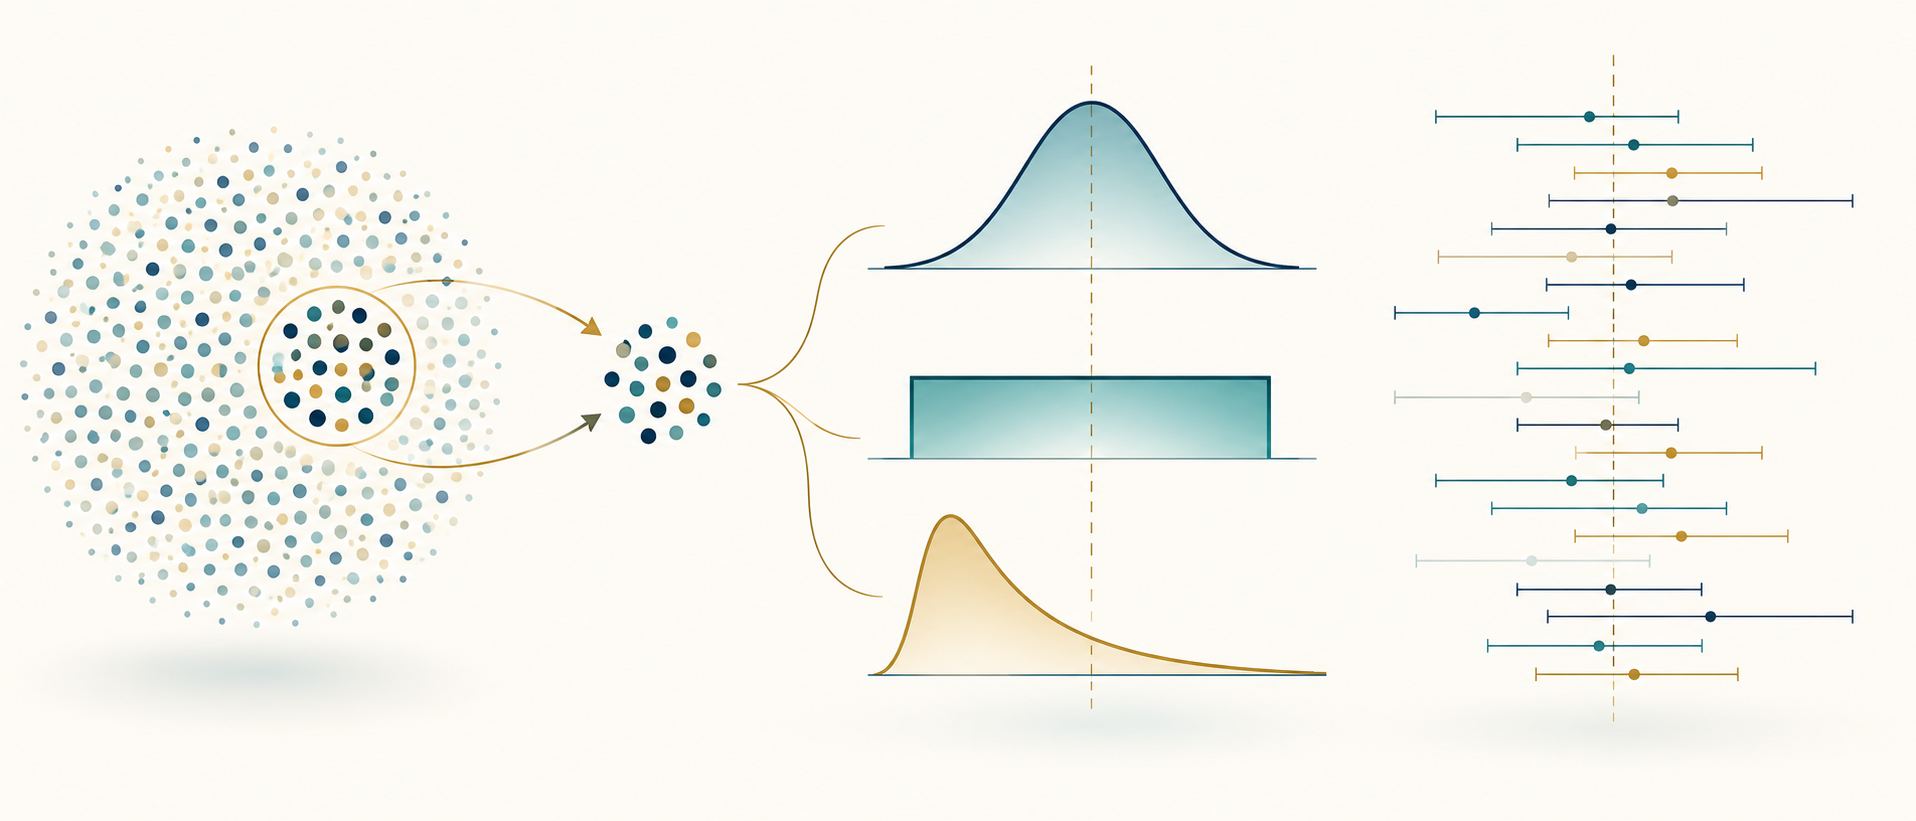
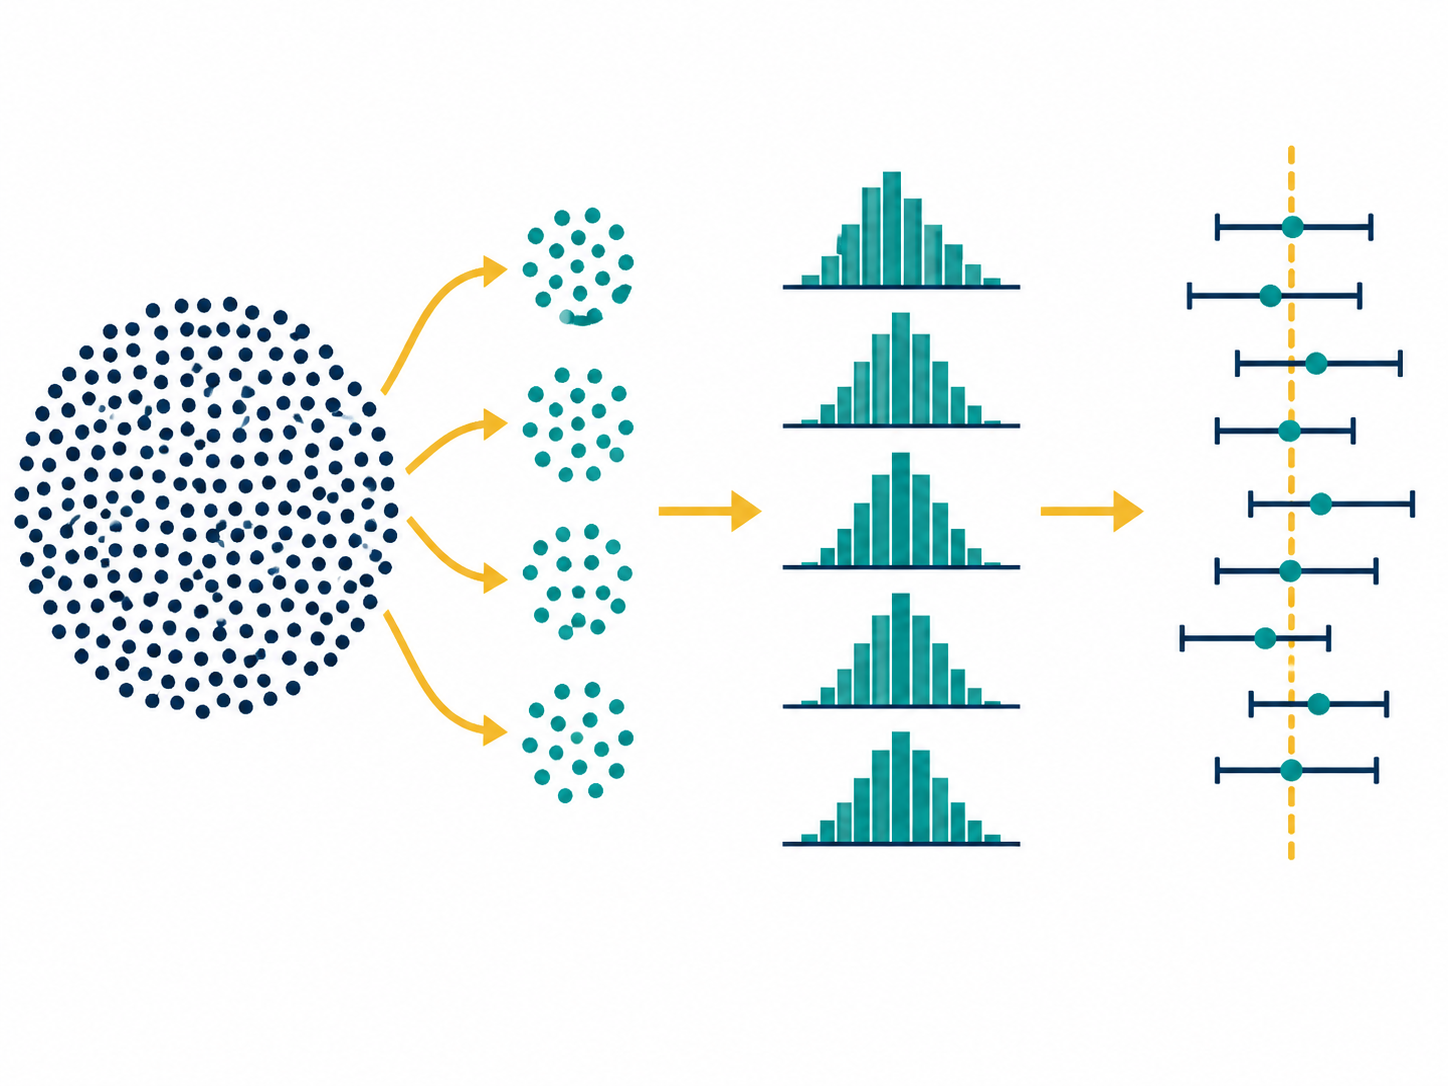
Une courbe de probabilité ne naît pas de l’histogramme : c’est un modèle utilisé pour décrire un phénomène et faire des prévisions. L’étape suivante consiste à comprendre ce que nous pouvons apprendre en observant seulement un échantillon. Nous suivrons un même fil : population → variable aléatoire → distribution → échantillon → statistique de l’échantillon → distribution de la statistique → intervalle de confiance. À la fin, chaque formule aura un sens et chaque simulation une question précise.
1. Expérience, variable aléatoire et distribution
Une expérience aléatoire a un résultat incertain avant l’observation, même si ses conditions sont définies. Une variable aléatoire X associe un nombre à chaque résultat possible : nombre de succès, temps d’attente, mesure. Si les valeurs possibles sont isolées, X est discrète ; si elle peut prendre des valeurs dans un intervalle, elle est continue. Une distribution attribue des probabilités aux valeurs possibles. Pour une variable discrète, on utilise P(X = x) ; pour une variable continue, une densité f(x), dont l’aire sur un intervalle donne une probabilité. En général P(X = x) = 0 pour une valeur continue isolée.
La fonction de répartition F(x) = P(X ≤ x) cumule la probabilité jusqu’à x. La moyenne théorique E(X) situe la distribution ; la variance Var(X) mesure la dispersion quadratique ; l’écart-type est sa racine carrée. Ce sont des propriétés du modèle, non des valeurs qui changent avec chaque échantillon. Un laboratoire utile montre simultanément formule, paramètres, graphique, sens et données simulées.
2. Les huit distributions du niveau de base
Bernoulli. Un essai a deux issues, codées 1 (succès) et 0 (échec), avec une probabilité de succès p, 0 ≤ p ≤ 1. P(X=1)=p; P(X=0)=1−p; E(X)=p; Var(X)=p(1−p). Exemple : réponse juste ou fausse. Simulez de nombreux essais et comparez la proportion de succès avec p : elles ne sont pas forcément identiques dans chaque série.
Binomiale. Compte les succès dans n essais de Bernoulli indépendants ayant la même p. Pour k de 0 à n, P(X=k)=C(n,k)p^k(1−p)^(n−k); E(X)=np; Var(X)=np(1−p). Exemple : le nombre de succès dans 20 lancers ou réponses. Modifiez n et p pour voir la forme évoluer et les fréquences simulées approcher les probabilités théoriques.
Poisson. Compte des événements dans un intervalle fixé lorsque le modèle suppose des événements indépendants à taux moyen constant λ > 0. Pour k = 0,1,2,…, P(X=k)=e^(−λ)λ^k/k!; E(X)=λ; Var(X)=λ. Exemple : arrivées pendant une période. Modifiez λ et observez le centre et la dispersion ; ne confondez pas le nombre d’événements avec le temps séparant deux arrivées.
Uniforme continue. Sur [a,b], avec a < b, des intervalles de même longueur ont la même probabilité : f(x)=1/(b−a) dans [a,b] et zéro ailleurs ; E(X)=(a+b)/2; Var(X)=(b−a)^2/12. Simulez un échantillon et comparez son histogramme imparfaitement plat à la densité théorique parfaitement plate.
Normale ou gaussienne. Continue et symétrique autour de la moyenne μ, elle est décrite par μ et σ > 0 : f(x)=[1/(σ√(2π))] exp(−(x−μ)^2/(2σ²)); E(X)=μ; Var(X)=σ². Faites varier μ pour déplacer la cloche et σ pour l’élargir. Son importance pour les moyennes d’échantillons ne signifie pas que tout phénomène réel soit Normal.
Exponentielle. Continue et non négative ; dans un modèle d’événements à taux constant, elle décrit le temps d’attente avec λ > 0 : f(x)=λe^(−λx) pour x ≥ 0 et zéro ailleurs ; E(X)=1/λ; Var(X)=1/λ². Simulez des attentes et observez la queue à droite. Poisson compte les événements ; l’Exponentielle mesure une attente dans le modèle correspondant.
t de Student. Continue et symétrique, elle dépend des degrés de liberté ν. Pour des observations Normales indépendantes et σ inconnue, T=(x̄−μ)/(s/√n) suit une loi t avec ν=n−1. Sa moyenne est nulle si ν > 1 et sa variance vaut ν/(ν−2) si ν > 2 ; pour de petits ν, ses queues sont plus épaisses que celles de la Normale. Superposez t et Normale centrée réduite lorsque ν augmente : l’écart se réduit.
Khi carré. Si Z₁,…,Zν sont des Normales centrées réduites indépendantes, χ²=Z₁²+⋯+Zν² possède ν degrés de liberté ; E(χ²)=ν; Var(χ²)=2ν. Elle est positive et asymétrique, surtout pour de petits ν. Elle sert à étudier la variance et à certains tests : ne confondez pas la distribution avec toutes les applications du test du khi carré. Le laboratoire dédié compare des effectifs observés et attendus.
3. Du modèle aux données observées
La distribution théorique décrit un modèle ; un échantillon de taille n en est une réalisation possible : X₁,…,Xₙ. On calcule x̄=(X₁+⋯+Xₙ)/n et s²=Σ(Xᵢ−x̄)²/(n−1). Le dénominateur n−1 fait de s² un estimateur sans biais de la variance dans un échantillonnage indépendant et identiquement distribué. Un nouvel échantillon du même modèle modifie x̄, s² et l’histogramme : cette variabilité n’est pas une erreur du programme.
Essayez : choisissez une distribution et ses paramètres, générez un échantillon, notez x̄ et s, puis demandez un nouvel échantillon sans changer le modèle. Répétez. Le paramètre de la population reste fixe ; les statistiques calculées changent. Avoir 100 observations ne signifie pas avoir 100 populations.
4. La distribution de la moyenne d’échantillon
Prélevons maintenant à répétition des échantillons entiers de même taille n, en ne gardant qu’une moyenne par échantillon. L’histogramme obtenu ne décrit pas les observations individuelles : il décrit la distribution d’échantillonnage de x̄. Pour des échantillons indépendants et identiquement distribués, de moyenne μ et de variance finie σ², E(x̄)=μ et SD(x̄)=σ/√n. Cette dernière quantité est l’erreur standard de la moyenne. Quadrupler n divise l’erreur standard par deux, sans l’annuler.
Le théorème central limite indique que, sous des conditions adaptées, la distribution de la moyenne standardisée tend vers la Normale quand n augmente. Si la population est Normale, la moyenne est Normale pour tout n ; pour une population uniforme ou exponentielle, on peut observer le rapprochement. Comparez n = 2, 5, 30 et 100 avec de nombreux échantillons, en plaçant côte à côte l’histogramme des valeurs individuelles et celui des moyennes. Une forte asymétrie ou la dépendance peut rendre l’approximation lente ou inappropriée.
5. Pourquoi un intervalle de confiance ?
La moyenne de l’échantillon estime μ, mais ne dit pas à elle seule avec quelle précision. Un intervalle de confiance construit autour de x̄ une bande qui change d’un échantillon à l’autre. Son niveau, par exemple 95 %, est la couverture à long terme de la procédure dans des répétitions idéales de la même expérience, sous les hypothèses du modèle. Une fois l’intervalle observé, μ est une valeur fixe : on ne dit pas qu’il a une probabilité de 95 % de s’y trouver. On ne dit pas non plus que 95 % des observations individuelles s’y trouvent.
6. Moyenne avec σ connu : intervalle z
Lorsque l’écart-type σ de la population est réellement connu et que la population est Normale, ou que n est assez grand pour justifier l’approximation, l’intervalle bilatéral est x̄ ± z_(1−α/2)·σ/√n au niveau 1−α. Les valeurs critiques habituelles sont 1,645 à 90 %, 1,960 à 95 % et 2,576 à 99 %. La marge d’erreur augmente avec le niveau demandé et avec σ, et diminue avec √n. Un s calculé sur l’échantillon ne doit pas être présenté comme un σ connu à l’avance.
Exemple. Si n=100, x̄=50, σ=10, à 95 % l’erreur standard vaut 1 et la marge 1,960 : l’intervalle est [48,04 ; 51,96]. À 99 %, la marge devient 2,576 et l’intervalle s’élargit. On gagne en couverture, non en précision.
7. Moyenne avec σ inconnu : intervalle t
En pratique σ est souvent inconnu. On utilise l’écart-type de l’échantillon s et un quantile de la t de Student : x̄ ± t_(1−α/2,n−1)·s/√n. Il y a n−1 degrés de liberté. Pour un petit échantillon, la justification exacte suppose une population Normale ; même avec des échantillons plus grands, il faut l’indépendance et de l’attention aux queues, aux valeurs aberrantes et au plan de collecte. Les queues plus épaisses de t donnent généralement un intervalle plus large que z pour les mêmes données.
Exemple. Pour n=16, x̄=75, s=12, l’erreur standard vaut 12/√16=3. À 95 %, avec 15 degrés de liberté, t≈2,131 ; la marge est environ 6,39 et l’intervalle [68,61 ; 81,39]. Comparez z et t pour n = 5, 10, 30 et 100 : leurs différences se réduisent lorsque n augmente.
8. Voir la couverture, et non seulement la lire
Fixez une population dont la moyenne μ est connue du simulateur, choisissez n et un niveau (90 %, 95 % ou 99 %), puis tirez 10, 100, 1 000 ou 10 000 échantillons indépendants. Construisez un intervalle pour chacun. Sur un graphique horizontal, tracez μ comme ligne verticale ; colorez différemment les intervalles qui la traversent et ceux qui la manquent. La couverture observée vaut intervalles contenant μ / tous les intervalles. Elle n’a pas à valoir exactement 95 % sur dix intervalles ; avec de nombreuses répétitions elle tend vers le niveau nominal si les hypothèses sont respectées.
Trois expériences guidées : réduisez n et voyez les intervalles s’allonger ; augmentez le niveau de confiance et comparez largeur et couverture ; passez de z à t lorsque σ est inconnu et observez le coût de cette incertitude. Une simulation de la couverture t doit recalculer s pour chaque échantillon, sans réutiliser un seul écart-type.
9. Organiser le laboratoire
Six modules interactifs rendent les transitions naturelles. Explorer une distribution : choisir parmi huit lois, modifier les paramètres et lire formule, forme et moyenne. Générer un échantillon : choisir n et examiner histogramme, x̄, s² et s. Répéter l’échantillonnage : recueillir de nombreuses moyennes et les comparer aux valeurs individuelles. Construire un intervalle : choisir 90 %, 95 % ou 99 %, distinguer σ connu et inconnu, puis voir chaque terme. Vérifier la couverture : répéter les tirages et colorer les intervalles selon qu’ils contiennent μ. Expériences guidées : répondre à « Que change le doublement de n ? » et « Pourquoi 99 % est-il plus large que 95 % ? », puis vérifier graphiquement.
Des graphiques lisibles sur téléphone, des curseurs affichant leur valeur, les boutons « Nouvel échantillon », « Répéter 100 », « Répéter 1 000 » et « Réinitialiser », de courtes explications près des résultats et des couleurs distinctes pour les paramètres théoriques, échantillons et intervalles aident davantage qu’un graphique spectaculaire. Une graine aléatoire facultative permet de reproduire une expérience. Le laboratoire existant permet l’analyse des données, la comparaison des modèles et le calcul des intervalles ; les modules d’échantillonnage répété et de couverture décrits ici sont des propositions d’extension pédagogique, non des fonctions supposées déjà présentes.
10. Cahier pédagogique pour un développement ultérieur
Les simulations de base peuvent fonctionner entièrement dans le navigateur, sans base de données. L’interface devrait permettre de choisir distribution, paramètres et taille de l’échantillon ; générer un échantillon et répéter 100 ou 1 000 fois ; séparer visuellement densité/probabilités théoriques, histogramme observé et histogramme des moyennes ; montrer pas à pas erreur standard et intervalles z/t ; comparer couvertures observée et attendue sans présenter un seul essai comme une loi. Les huit distributions demandent des contrôles des domaines des paramètres et des tests numériques ; les intervalles exigent des vérifications des quantiles, degrés de liberté et cas limites. Une bibliothèque graphique stable peut produire des figures adaptatives, mais les formules statistiques doivent être implémentées et vérifiées explicitement.
Un panneau « Explique-moi » devrait relier chaque commande à une question : « Qu’est-ce qui reste fixe dans la population ? », « Qu’est-ce qui change entre les échantillons ? », « Quelle distribution cet histogramme représente-t-il ? », « Que signifie 95 % ? ». L’interface doit apprendre à interpréter, pas seulement produire des réponses.
11. Extensions possibles
Après le niveau de base, on peut ajouter les intervalles pour une proportion, les intervalles pour la variance utilisant le khi carré, la comparaison de deux moyennes ou proportions, le bootstrap, les tests d’hypothèse, les tests d’adéquation, l’import CSV et les graphiques Q-Q. Chaque extension requiert ses propres hypothèses : ce n’est pas simplement un autre bouton appliqué sans distinction aux mêmes données. Le lien naturel avec le laboratoire existant consiste à passer avec discernement de l’exploration des données à l’inférence.
Conclusion
La théorie explique ce qu’on peut attendre ; la simulation montre ce qui varie réellement ; l’intervalle quantifie l’incertitude d’une estimation. Avant de cliquer, demandons-nous toujours quelle est la population, quelle variable nous mesurons, comment l’échantillon a été prélevé et quelle statistique nous regardons. C’est cette chaîne, et non une formule isolée, qui rend compréhensible la probabilité appliquée.
Ouvrir le nouveau laboratoire guidé en six étapes
Ouvrir le laboratoire des distributions et des intervalles de confiance