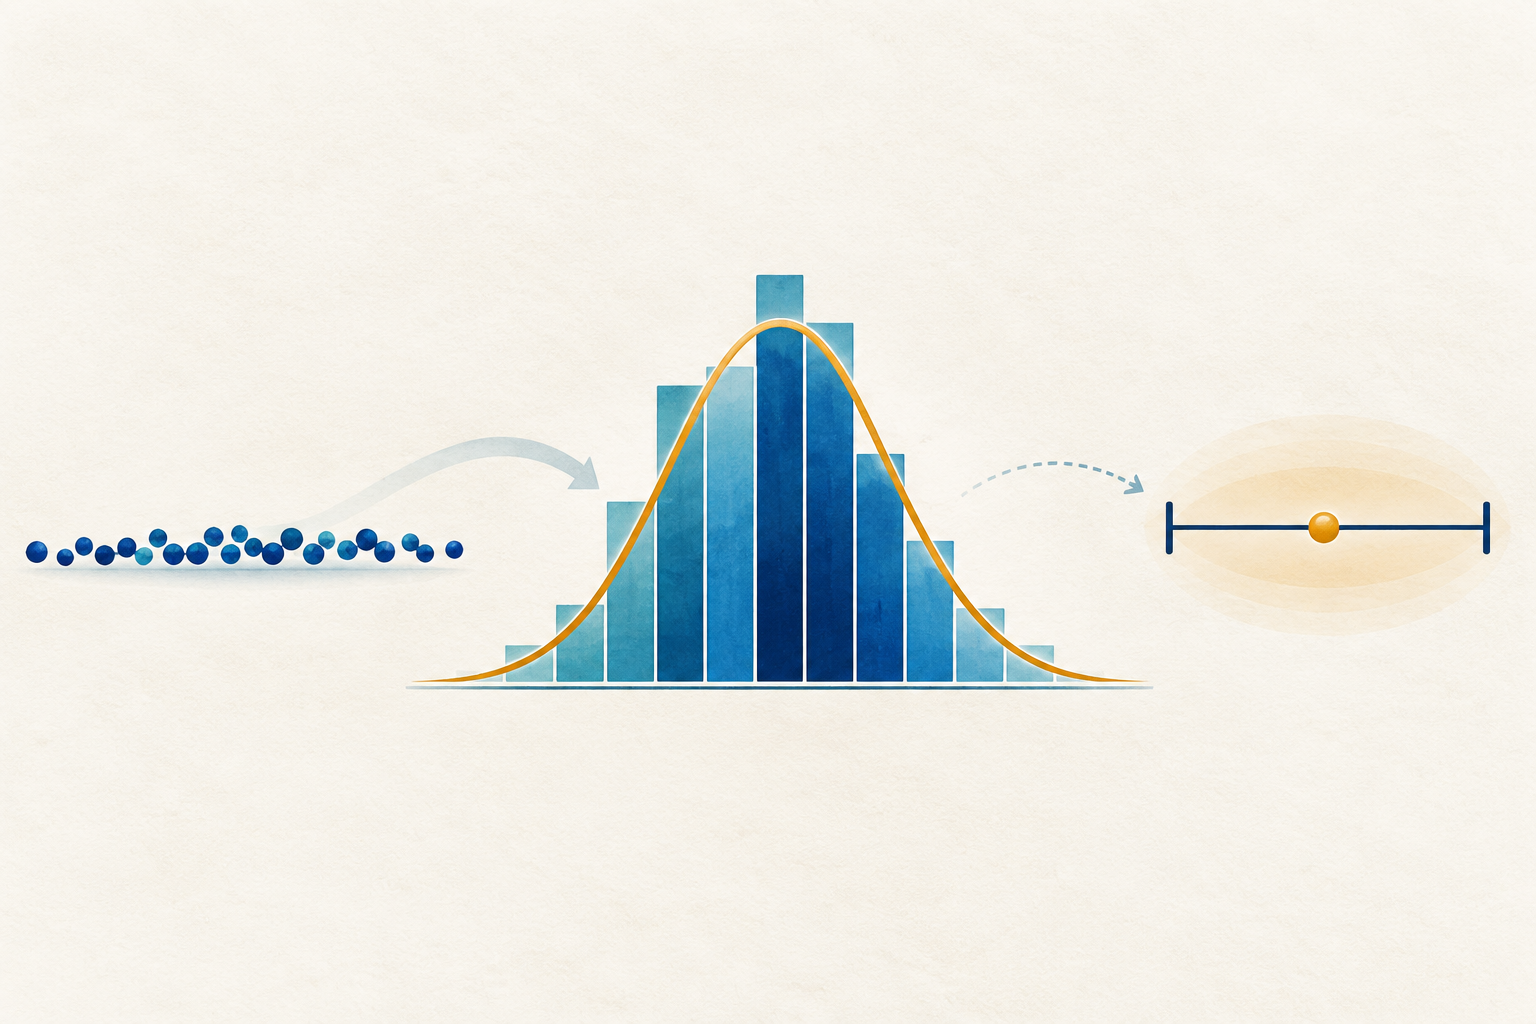
Nous recueillons des mesures. Nous traçons un histogramme et une courbe semble bien le suivre. Avons-nous découvert la loi qui gouverne le phénomène ? Pas encore. Nous avons construit un modèle possible, à comparer à d’autres et à interpréter à la lumière de la collecte des données. Le laboratoire des distributions permet de suivre ce parcours avec ses propres chiffres.
De l’échantillon à la population
La population est l’ensemble sur lequel nous voulons conclure ; l’échantillon contient les n observations réellement disponibles. La moyenne de l’échantillon x̄ estime la moyenne inconnue μ de la population. L’écart-type de l’échantillon s décrit la dispersion des valeurs autour de x̄. Un autre échantillon pourrait donner une autre moyenne : une estimation ponctuelle ne traduit donc pas toute l’incertitude.
Avant de calculer, demandons-nous si les observations sont indépendantes, si l’échantillon est représentatif et si chaque valeur a le même sens. Un calcul parfait ne corrige pas un échantillon mal choisi.
Que raconte un histogramme ?
Un histogramme regroupe les mesures en intervalles. Dans le laboratoire, la hauteur des barres représente des densités : l’aire totale des barres vaut 1 et des courbes continues peuvent être superposées. La forme dépend aussi du choix des classes : une apparente forme en cloche ne démontre pas, à elle seule, la normalité.
Pour les mesures continues, le laboratoire essaie les lois normale, uniforme et exponentielle ; si toutes les valeurs sont strictement positives, il ajoute les lois lognormale et Weibull. Les comptages entiers disposent d’un onglet distinct : Poisson et, si le nombre d’essais par observation est connu, Binomiale. Une courbe de densité continue et les probabilités de comptages particuliers ne sont pas la même chose.
Les distributions en bref
Une distribution modélise les probabilités des résultats possibles. Le type de données compte avant le nom de la courbe : une mesure peut varier continûment, tandis qu’un comptage ne prend que des valeurs entières.
- Normale : un modèle en cloche symétrique décrit par la moyenne μ et l’écart-type σ.
- Uniforme : dans un intervalle [a, b], des sous-intervalles de même longueur ont la même probabilité.
- Exponentielle : décrit des temps d’attente non négatifs quand le taux des événements reste constant ; son paramètre est λ.
- Lognormale : décrit des valeurs positives dont les logarithmes suivent une loi normale ; elle présente souvent une longue queue à droite.
- Weibull : modélise des durées positives ; forme et échelle permettent différents profils.
- Poisson : compte les événements dans un intervalle fixé à partir d’un nombre moyen λ.
- Binomiale : compte les succès dans m essais indépendants ayant chacun une probabilité p.
Comparer des modèles sans proclamer de vainqueur absolu
Chaque modèle possède des paramètres estimés à partir des données. Le laboratoire compare la répartition cumulée observée à celle du modèle au moyen d’une distance D : parmi les candidats affichés, une D plus petite indique une meilleure concordance descriptive. Elle ne prouve pas que le modèle soit la vraie distribution et elle n’est pas une valeur p. En particulier, les paramètres sont estimés sur le même échantillon : on ne peut donc pas appliquer automatiquement les valeurs critiques du test standard de Kolmogorov–Smirnov.
Il faut lire ce classement avec l’histogramme, la nature du phénomène et la taille de l’échantillon. Si des modèles plausibles manquent, même le premier candidat peut être inadapté.
Le test du khi carré : observé et attendu
Si les résultats sont répartis en catégories et si les probabilités de l’hypothèse nulle H₀ sont fixées avant les données, on peut comparer les effectifs observés O aux effectifs attendus E = N × p. La statistique est χ² = Σ (O − E)² / E : de grands écarts relativement aux attentes donnent une valeur plus élevée. La valeur p indique à quel point un écart au moins aussi grand serait inhabituel si H₀ était correcte ; ce n’est pas la probabilité que H₀ soit vraie.
Dans le laboratoire du test du khi carré, vous pouvez suivre le calcul catégorie par catégorie et essayer un dé, une loi de Poisson avec λ connu et une loi binomiale à paramètres connus. Les observations doivent être indépendantes et chaque effectif attendu doit valoir au moins 5. Si les paramètres sont estimés à partir des mêmes données, comme pour les modèles ajustés ci-dessus, les degrés de liberté demandent un traitement différent : il ne faut pas réutiliser la simple valeur p de ce laboratoire pour ces modèles. Référence NIST.
Un intervalle pour la moyenne, pas pour les observations individuelles
La moyenne x̄ est un nombre ; un intervalle de confiance ajoute une marge exprimant l’incertitude sur l’estimation de μ. Si l’écart-type σ de la population est connu, l’intervalle bilatéral utilise une valeur critique z et l’erreur type σ/√n. Plus souvent, σ est inconnu : on utilise s et une valeur critique de la loi t de Student à n−1 degrés de liberté :
IC pour μ = x̄ ± t1−α/2,n−1 · s/√n.
Le laboratoire propose des niveaux de confiance de 90 %, 95 % et 99 %. À données égales, plus de confiance signifie un intervalle plus large ; quand n augmente, l’erreur type tend à diminuer. Pour les petits échantillons, la méthode t exige une attention particulière à l’hypothèse d’une population approximativement normale.
Un calcul pas à pas
Supposons n = 16 poids avec x̄ = 75 kg et s = 12 kg, sans connaître σ. L’erreur type vaut 12/√16 = 3 kg. Au niveau 95 %, avec 15 degrés de liberté, la valeur critique est environ 2,1314. La marge vaut 2,1314 × 3 ≈ 6,39 kg et l’intervalle est [68,61 ; 81,39] kg.
Si σ = 12 kg était réellement connu indépendamment de l’échantillon, nous utiliserions z ≈ 1,9600 : l’intervalle deviendrait [69,12 ; 80,88] kg. Avec n = 100, tout en conservant x̄ = 75 kg et s = 12 kg, l’intervalle t à 95 % serait environ [72,62 ; 77,38] kg. Ce n’est pas de la magie : sous les hypothèses de la méthode, davantage de données réduisent l’erreur type.
Que signifie vraiment « 95 % » ?
La moyenne μ de la population ne change pas après l’observation de l’échantillon. Le 95 % décrit la procédure : si nous répétions de nombreux échantillonnages dans les mêmes conditions, environ 95 intervalles sur 100 construits de cette façon contiendraient μ. Cela ne signifie pas que 95 % des personnes ont une valeur dans cet intervalle et n’attribue pas une probabilité de 95 % à un μ déjà fixé.
Si les données sont très asymétriques, comportent des valeurs aberrantes ou proviennent d’un échantillon biaisé, l’intervalle classique peut induire en erreur. Le laboratoire signale certaines précautions, mais ne peut pas déterminer seul comment l’échantillonnage a été conçu.
Mettons les idées à l’épreuve
Dans le laboratoire interactif, vous pouvez coller de 5 à 2 000 mesures, examiner l’histogramme et les modèles, puis calculer un intervalle pour la moyenne ; vous pouvez aussi saisir directement n, x̄ et s ou σ si vous ne disposez que de statistiques résumées. Un onglet séparé analyse les comptages et le mode « Mettez-moi à l’épreuve » cache la distribution génératrice. Sept exemples détaillés montrent comment les intervalles changent. Les données saisies restent dans votre navigateur.
Ouvrir le laboratoire des distributions et des intervalles de confiance
Pour approfondir : NIST, intervalles de confiance pour la moyenne et NIST, limites de la comparaison Kolmogorov–Smirnov.